

Rodrigo Fernández (GESMar UNMdP HLab) y Agustín Nieto (INHUS Conicet UNMdP HLab)
EntropIA Lite es una aplicación de escritorio, gratuita y de código abierto, desarrollada en HLab (un laboratorio digital para las ciencias sociales radicado en Mar del Plata que reúne investigadores del CONICET y de la Universidad Nacional de Mar del Plata) para organizar, procesar y consultar materiales documentales de distinta naturaleza. Reúne en un mismo entorno fotografías de archivo, imágenes, PDF escaneados, audios de entrevistas y otros documentos, y permite convertirlos en información textual susceptible de búsqueda y análisis. El propósito de este artículo es presentar sus principales funciones, explicar de manera sintética su lógica de trabajo y explicitar algunas de las decisiones metodológicas que orientaron su desarrollo.
Qué es y qué hace
EntropIA Lite se instala como una aplicación de escritorio y no requiere suscripción. Su código es abierto, es decir que cualquier persona interesada puede examinar cómo está construida, adaptarla o modificarla de acuerdo con sus necesidades. La aplicación busca reducir las barreras técnicas que suelen acompañar el uso de herramientas de procesamiento documental, de modo que la instalación, la configuración y las tareas habituales puedan resolverse desde la propia interfaz.
Fue concebida principalmente para el trabajo en ciencias sociales y humanidades, aunque puede resultar útil para cualquier investigación que combine fuentes analógicas digitalizadas y documentos nacidos digitales. Su diseño procura conservar la relación entre el documento original, los distintos procesamientos realizados sobre él y las intervenciones posteriores de quien investiga.
Los documentos se organizan en colecciones (Figuras 1 y 2), entendidas como espacios de trabajo que pueden corresponder a un tema, un proyecto, un archivo o cualquier otro criterio definido por quien utiliza la aplicación. Sobre esos materiales pueden ejecutarse, de manera independiente o combinada, los siguientes procesos:
-
Reconocimiento óptico de caracteres (OCR): transforma imágenes y PDF escaneados en texto y permite conservar la referencia al documento de origen.
-
Transcripción de audio: convierte entrevistas y grabaciones en texto e identifica, cuando el servicio utilizado lo permite, los distintos hablantes.
-
Detección y estructuración de información: identifica entidades -como personas, organizaciones, lugares y fechas- y permite extraer relaciones expresadas en forma de tripletas semánticas (sujeto, predicado y objeto).
-
Indexación y recuperación de información: combina búsqueda por texto completo con búsqueda semántica, de modo que es posible localizar tanto términos exactos como fragmentos conceptualmente próximos, aun cuando no compartan las mismas palabras.
-
Anotación y edición: permite incorporar notas y etiquetas, corregir el texto obtenido mediante OCR o transcripción y revisar manualmente los resultados producidos por los modelos.
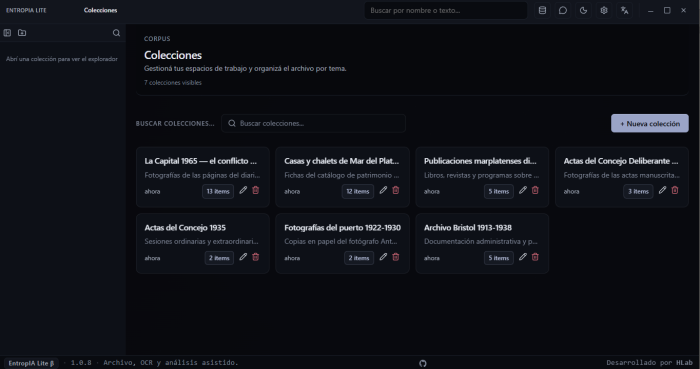
Figura 1. Pantalla de colecciones
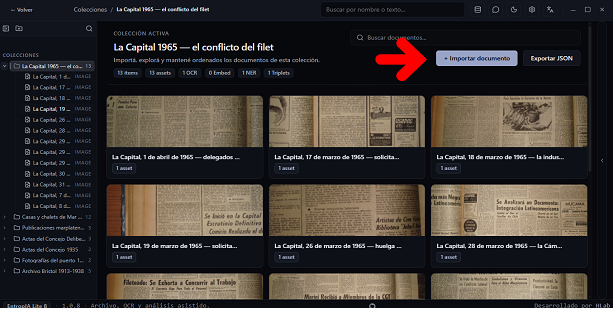
Figura 2. Importación de documentos: imágenes, PDF y audios.
Base de datos y persistencia del trabajo
Cada colección se apoya en una base de datos local SQLite que registra los documentos incorporados y las distintas capas de información generadas durante el trabajo: textos extraídos, transcripciones, anotaciones, entidades, relaciones, fragmentos utilizados para recuperación, índices y otros resultados derivados. La base de datos no reemplaza a los archivos originales, sino que funciona como una estructura de persistencia que mantiene vinculados los materiales, los procesos ejecutados y sus resultados. Esto evita que el trabajo quede disperso en archivos independientes y permite retomar una colección sin reconstruir manualmente su estado.
La persistencia local cumple además una función metodológica: hace posible distinguir la fuente de los datos producidos por cada operación y conservar un registro de las intervenciones posteriores. De ese modo, una entidad detectada, una tripleta o una corrección manual pueden ser revisadas en relación con el documento del que proceden.
Chat y consulta del corpus
EntropIA incorpora también un espacio de conversación para consultar el corpus en lenguaje natural. El chat no trabaja sobre una colección abstracta ni sustituye la lectura de las fuentes: recupera información a partir del material previamente incorporado, procesado e indexado en la aplicación. Las respuestas se construyen sobre fragmentos recuperados del corpus, de manera que la conversación funciona como una vía adicional de exploración y no como una fuente independiente de conocimiento.
Esta separación entre procesamiento y consulta es deliberada. El OCR, la transcripción, la detección de entidades, la extracción de relaciones y la generación de representaciones semánticas se realizan sobre los documentos y quedan almacenados como resultados reutilizables. El chat consulta esa base ya procesada, lo que permite evitar operaciones redundantes y mantener una relación más clara entre la respuesta generada y la evidencia documental disponible.
Búsqueda, similitud y navegación entre documentos
Además de la búsqueda por palabras, la aplicación genera representaciones vectoriales que permiten localizar documentos o fragmentos semánticamente similares. Esta función resulta útil para recorrer un corpus a partir de afinidades temáticas o discursivas que no siempre pueden anticiparse mediante una lista de términos. La recuperación semántica se integra con la búsqueda textual y con la navegación por colecciones, de modo que los resultados pueden volver a examinarse en su contexto documental.
Importación, exportación y reutilización
El flujo de trabajo está pensado para que la información producida dentro de EntropIA no quede encerrada en la interfaz. Los documentos y sus resultados pueden organizarse y revisarse dentro de la aplicación y, cuando corresponde, exportarse en formatos estructurados -por ejemplo, JSON- para continuar el análisis con otras herramientas. Esta posibilidad es especialmente importante en proyectos que combinan lectura documental, análisis cualitativo y procesamiento computacional (Figuras 3 y 4).
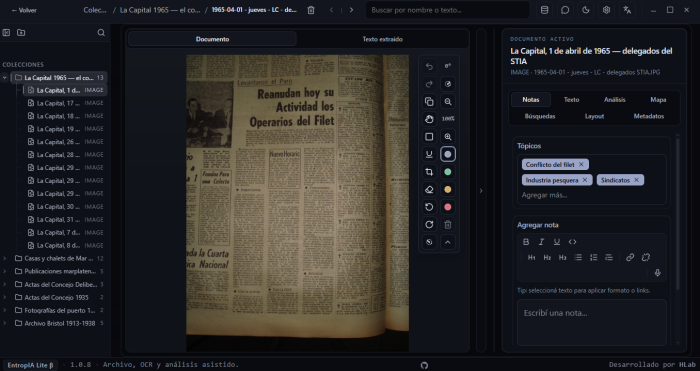
Figura 3. Ficha de documento: fuente original y espacio de anotación
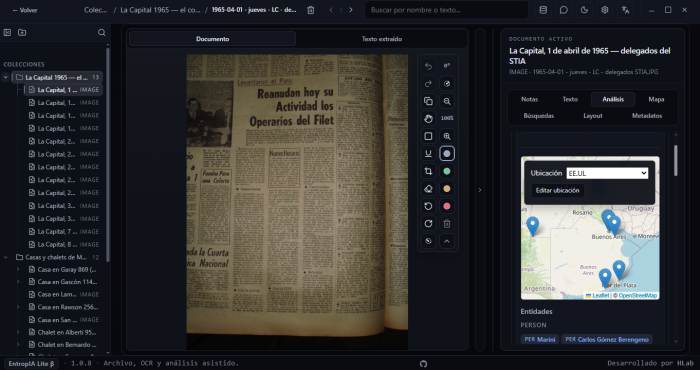
Figura 4. Panel de análisis: entidades detectadas y relaciones semánticas
La aplicación no está pensada como una sucesión de servicios aislados, sino como un entorno de trabajo en el que cada transformación permanece vinculada con su fuente. El documento original, el texto extraído, las anotaciones, las entidades, las relaciones y los índices de búsqueda forman parte de un mismo espacio de consulta. Esta organización permite revisar los resultados, corregirlos y volver sobre las decisiones tomadas durante el procesamiento, en lugar de tratar las salidas de los modelos como resultados finales e irreversibles.
Dos variantes
EntropIA se distribuye en dos variantes que comparten una misma lógica de trabajo, pero difieren en las modalidades de procesamiento que ofrecen. EntropIA Pro combina el procesamiento local con el acceso a proveedores externos mediante API, lo que permite ejecutar en la propia computadora buena parte de las tareas, siempre que se disponga del hardware necesario, como también recurrir a los mismos servicios externos (Z.ai, OpenRouter, AssemblyAI) disponibles en EntropIA Lite.
EntropIA Lite, en cambio, está orientada exclusivamente al procesamiento mediante API, de modo que las tareas que requieren modelos externos se realizan a través de proveedores seleccionados por el usuario. En estos casos, los documentos o fragmentos necesarios se envían al servicio correspondiente y la aplicación recibe los resultados del procesamiento. Esta arquitectura permite adaptar el flujo de trabajo a equipos con capacidades muy distintas y, en la versión Pro, elegir entre procesamiento local y remoto según las características de cada tarea.
Cuando se utilizan servicios externos, resulta además necesario considerar sus condiciones de uso, sus políticas de tratamiento de datos y sus costos. Por ejemplo, AssemblyAI otorga cincuenta dólares de crédito al registrarse, sin requerir tarjeta. OpenRouter cobra por token según el modelo que se seleccione y Z.ai requiere cargar un mínimo de cinco dólares, suficiente para realizar una gran cantidad de operaciones de OCR.
¿Cómo empezar?
Para comenzar a utilizar EntropIA Lite es necesario instalar la aplicación y cargar las claves de acceso requeridas por los servicios que se deseen utilizar (Figura 5). La configuración predeterminada emplea OpenRouter para los modelos de lenguaje, AssemblyAI para la transcripción y Z.ai para el OCR. Los modelos disponibles a través de OpenRouter pueden modificarse desde la pantalla de configuración, sin necesidad de alterar archivos ni recurrir a herramientas externas.
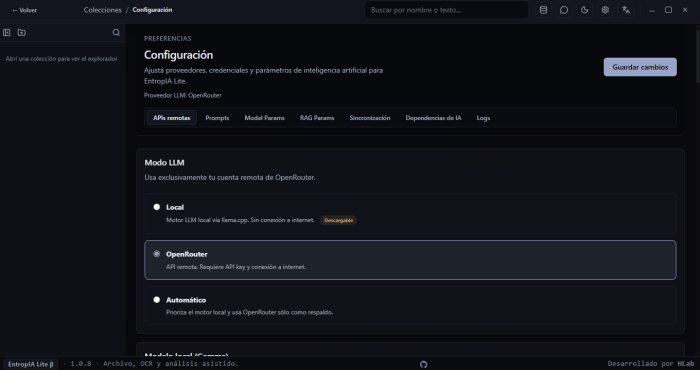
Figura 5. Configuración de proveedores, claves de acceso y modelos
¿Por qué una app más?
EntropIA surgió de un problema de trabajo concreto: reunir materiales documentales dispersos, procesarlos con herramientas diferentes y, sobre todo, evitar que cada etapa produjera archivos y resultados difíciles de relacionar entre sí. Por estas razones decidimos desarrollar una aplicación propia.
Esta decisión tiene también una dimensión metodológica. Las herramientas digitales no son recipientes neutrales: su diseño establece qué operaciones resultan sencillas, cuáles quedan ocultas y qué vínculos pueden mantenerse entre una fuente y los datos derivados de ella. Por esa razón, EntropIA procura hacer visibles los procesos aplicados a cada documento y conservar la posibilidad de inspeccionar, corregir y contrastar sus resultados. El objetivo no es automatizar la investigación como un procedimiento cerrado, sino integrar recursos de inteligencia artificial dentro de un flujo de trabajo trazable, en el que las decisiones analíticas permanezcan bajo control de quien investiga. En este sentido, la aplicación busca contribuir a una apropiación crítica de estas tecnologías: comprender qué hacen, en qué condiciones resultan útiles y dónde aparecen sus límites.
Próximos pasos
Como continuidad de este trabajo, estamos desarrollando herramientas complementarias orientadas al procesamiento de corpus de mayor escala, en particular textos nacidos digitales: publicaciones de redes sociales y plataformas de microblogging, comentarios de lectores, notas periodísticas y otras colecciones que requieren procedimientos específicos de recolección, clasificación y análisis.
Dónde conseguirla
EntropIA Lite puede descargarse desde Microsoft Store o desde la sección de versiones del repositorio del proyecto. El código fuente y la documentación técnica de EntropIA Lite y EntropIA Pro se encuentran en github.com/HumaLab/EntropIA-Pro-Lite. En hlab.com.ar se presentan otros desarrollos del laboratorio y se ofrece información sobre EntropIA Web.